Julia/Lux.jl で拡散モデルを実装する
この記事は JuliaLang Advent Calendar 2022 14日目の記事である。
最近趣味で、Lux.jl という Julia 製のニューラルネットのフレームワークを使って拡散モデルを実装していた。
学習データには Oxford 102 flowers dataset という花のデータセットを使っていて、うまく学習できると以下のような画像が生成できる
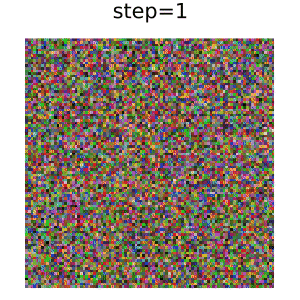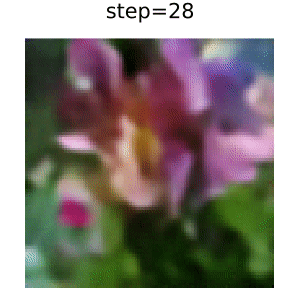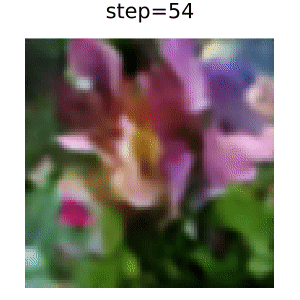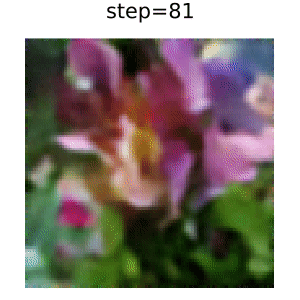
使える計算リソースのせいであまり解像度の高いものは作れないが、それでもそれっぽい画像は生成できるようになった。
それで作ったものを適当に twitter に貼ったり、(@MathSorcerer さんの勧めで)Julia discourse に投げたりしていたら、最終的に Lux.jl の公式 example にコミットすることになり、先日無事マージされた。
Julia は個人的に良い言語だとずっと思っているのだけど、機械学習分野では python エコシステムの圧倒的な物量の前にいまいち目立たない存在となっている。それでも最近は、GPU を使った深層学習までできるくらいには色々揃ってきているよう。
今回は拡散モデルという題材で、 Lux.jl やその周辺のエコシステムを使って深層学習モデルを実装する方法を紹介したい。Julia の深層学習関連の記事は日本語でもいくつかあるが、自分でレイヤーをカスタマイズしないといけないようなそれなりに複雑なネットワークを構築している例は少ない。この記事が実践的な深層学習モデルを実装する例として参考になれば良いと思う。
Disclaimer だが、自分の Julia の経験は、博士課程の研究で使った+趣味で時々触っている程度なので、内容に間違いがあったらコメントしてほしい。あと、タイトルに拡散モデルと書きながら、拡散モデルについての話題はほとんど出てこないのも許してほしい。
拡散モデルについて
拡散モデルは目下大流行中の深層生成モデルで、ランダムな入力から少しずつノイズを除去することで高品質の画像を得ることができる。ググってもらえれば英語でも日本語でも記事はたくさんヒットすると思うので、ここで詳しくは説明しない。一応自分が書いた記事もある。
今回は Keras の example を Julia で再実装した。
ここで扱っているのは Denoising Diffusion Implicit Models (DDIM) というもので、それ以前の DDPM などの拡散モデルからの生成をより高速に行えるように改良したものになっている。
また Jax での実装(daigo0927/jax-ddim)もあったので参考にしている。
Julia の深層学習関連のパッケージ
Flux と Lux
Julia にはいくつかニューラルネットワーク用のパッケージが存在するが、中でも最も有名なのは Flux.jl だろう。これは立ち位置としては TensorFlow や PyTorch に近い。これらが、モデルをクラスで定義するのと同様に、Flux では NN レイヤーを trainable パラメータを持った構造体で定義する。またデータローダーや activation function も搭載している(実際には NNlib.jl や MLUtils.jl を re-export している)。
一方今回扱う Lux.jl は python でいうと Jax/Haiku などのフレームワークに近い。Lux が提供するのはレイヤーの管理機能のみであり、その他の機能は外部のパッケージと連携する必要がある。また、Lux でのレイヤー構造体はモデルの構造を決めるための情報(例えば入力と出力の次元数)だけを保持しており、内部に trainable なパラメータを持たない。Lux のドキュメントには
- Functional Design – Pure Functions and Deterministic Function Calls.
- No more implicit parameterization.
- Compiler and AD-friendly Neural Networks
とあり、Jax 周りのフレームワークと同様に pure function を志向していることがわかる。
このような設計を採用した理由についてはドキュメントの Why use Lux over Flux? によくまとまっていて、かいつまんでまとめると、パラメーターを explicit に扱う方が(Julia の機械学習界隈で盛んな)Neural ODE などとの相性が良くなるかららしい。
深層学習のエコシステム
Julia のエコシステムには composability 1 と呼ばれる設計思想のようなものがあって、独立した小さなパッケージをユーザーが自由に組み合わせて開発することが良しとされている。上で書いたように Lux.jl 単独では深層学習はできず、データローダーであったりオプティマイザであったり、はたまた画像や言語処理用の機能は別のパッケージを利用して実装する必要がある。この辺りは、TensorFlow や PyTorch とは対照的であると思う。
ということで、ここでは Julia でニューラルネットを実装するときによく使うパッケージをリストアップする
- Zygote.jl: Backward の自動微分のデファクトスタンダード。TensorFlow や PyTorch ではそれぞれ独自の tensor 型を定義してその上で微分を行うが、Zygote は Julia の標準の配列などを使ってそのまま微分ができるのが特徴。
- NNlib.jl: Activation function などが実装されている。先述のように Zygote を使えば自分で好きに定義した関数で微分ができるのだが、同じ関数でも実装方法によって numerical stability に差が出ることもあるので、NNlib に存在するものは積極的に利用した方が良い。
- MLUtils.jl: データローダーなどの utility が実装されている。PyTorch のデータローダーのように、スレッド並列でデータを読み込む機能もついている。
- Optimisers.jl: 名前の通りオプティマイザの実装がある。
Lux.jl でニューラルネットワークを実装する
前置きが長くなってしまったが、DDIM の実装を通して、Lux の使い方を見ていこう。なお DDIM やそのバックボーンである UNet などの内容はとても説明しきれないので、上に貼った Keras の example やリポジトリの実装を参考にしてほしい。ここでは Lux を使う上でのキーポイントに絞って記すことにする。
モデルの定義
実装済みのレイヤーを利用する
UNet アーキテクチャの部品の一つである residual_block の定義を見てみよう。これは入力と出力の画像のチャネル数をもとに、レイヤーを返す関数である。
function residual_block(in_channels::Int, out_channels::Int)
    if in_channels == out_channels
        first_layer = NoOpLayer()
    else
        first_layer = Conv((3, 3), in_channels => out_channels; pad=SamePad())
    end

    return Chain(first_layer,
                 SkipConnection(Chain(BatchNorm(out_channels; affine=false, momentum=0.99),
                                      Conv((3, 3), out_channels => out_channels; stride=1,
                                           pad=(1, 1)), swish,
                                      Conv((3, 3), out_channels => out_channels; stride=1,
                                           pad=(1, 1))), +))
end畳み込みやバッチ正規化などよく使うレイヤーは、Conv や BatchNorm として Lux に実装済み。現状実装されているレイヤーはドキュメントを参照してほしい。
Lux ではレイヤーを直列に繋げる場合、Chain を使う。Keras の Sequential のようなイメージ。また SkipConnection(some_layer, +) で $\boldsymbol x + f(\boldsymbol x)$ 型のスキップコネクションが定義できる。
今回は、入力チャネル数 in_channel と出力チャネル数 out_channel が異なる場合のみ、チャネル数を揃えるための畳み込み層を追加しているが、このような分岐は if と NoOpLayer を Chain と組み合わせて実現できる。
Keras の functional API や PyTorch-like なモデルの定義をするには、以下で説明するようなカスタムレイヤーを実装する必要がある。
カスタムレイヤーを実装する
単純な構造のモデルは上のように実装すれば良いが、今回使う UNet はダウンサンプリング・ブロックとアップサンプリング・ブロックとの間でスキップコネクションが発生し、単純に Chain と SkipConnection を組み合わせるだけで実装するのは難しい。また DDIM は入力画像にノイズを付与して UNet を呼び出すというような処理が必要になる。このようなケースでは自前でレイヤーを定義して柔軟な処理を実装する方が良いだろう。今回実装した DenoisingDiffusionImplicitModel もカスタムレイヤーを使用しており、概略を示すと以下のようになる。
struct DenoisingDiffusionImplicitModel{T <: AbstractFloat} <:
       Lux.AbstractExplicitContainerLayer{(:unet, :batchnorm)}
    unet::UNet
    batchnorm::BatchNorm
    min_signal_rate::T
    max_signal_rate::T
end

# コンストラクタ
function DenoisingDiffusionImplicitModel(image_size::Tuple{Int, Int};
                                         channels=[32, 64, 96, 128], block_depth=2,
                                         min_freq=1.0f0, max_freq=1000.0f0,
                                         embedding_dims=32, min_signal_rate=0.02f0,
                                         max_signal_rate=0.95f0)
    unet = UNet(...)
    batchnorm = BatchNorm(...)

    return DenoisingDiffusionImplicitModel(unet, batchnorm, min_signal_rate,
                                           max_signal_rate)
end

# モデル呼び出し
function (ddim::DenoisingDiffusionImplicitModel{T})(x::Tuple{AbstractArray{T, 4},
                                                             AbstractRNG}, ps,
                                                    st::NamedTuple) where {
                                                                           T <:
                                                                           AbstractFloat}
    images, rng = x
    # noises を生成し、images + noises から pred_noises, pred_image を得る
    ...
    return (noises, images, pred_noises, pred_images), st
end
Lux のレイヤーは全て Lux.AbstractExplicitLayer の subtype になる。レイヤーが内部に別のレイヤーを含んでいる場合は、Lux.AbstractExplicitContainerLayer の subtype にする。さらに (:unet, :batchnorm) のようにパラメータを与えることで、モデルパラメータの追跡を容易にできる。この辺の書き方は少し面倒かもしれない。カスタムレイヤーについて詳しくはドキュメントを参照してほしい。
DDIM 呼び出しの入力となっている ps はモデルの trainable なパラメータ、st はバッチ正規化レイヤーの statitics 情報など、レイヤーの状態を表す trainable でない変数である。Lux のレイヤーはこの例のように、(data, model parameter, model state) の三つ組をレイヤーの入力とし、(result, updated state) を返すように実装する。ps や st の初期化についてはこの後説明する。
ロス関数
上で述べたように、Zygote は好きな Julia の関数を微分してくれるので、モデルの出力を使ってロスを好きに定義する。ここではモデル ddim と共にパラメータ ps と状態 st を明示的に受け取る次のような関数を定義した。
function compute_loss(ddim::DenoisingDiffusionImplicitModel{T}, images::AbstractArray{T, 4},
                      rng::AbstractRNG, ps, st::NamedTuple) where {T <: AbstractFloat}
    (noises, images, pred_noises, pred_images), st = ddim((images, rng), ps, st)
    noise_loss = mean(abs.(pred_noises - noises))
    image_loss = mean(abs.(pred_images - images))
    loss = noise_loss + image_loss
    return loss, st
end
学習
データローダー
データローダーは MLUtils.jl の DataLoader を使うのが便利。以下のようにデータセットと、バッチ化のオプションを渡す。
ds = ImageDataset(dataset_dir, x -> preprocess_image(x, image_size), true)
data_loader = DataLoader(ds; batchsize=batchsize, partial=false, collate=true,
                            parallel=true, rng=rng, shuffle=true)
DataLoader に渡すデータセットは Julia の構造体で、以下の二つのメソッドを備えていればなんでも良い
length(ds::ImageDataset): データセットのサイズgetindex(ds::ImageDataset, i::Int):i番目のデータの取得
そのため RAM に乗り切らないデータはディスクから読むというような状況にも対応できる。PyTorch のデータローダーを意識して設計されている気がする。
初期化
モデルの初期化は Lux.setup で、オプティマイザの初期化は Optimisers.setup で行う。
rng = Random.MersenneTwister()

ddim = DenoisingDiffusionImplicitModel((image_size, image_size); channels=channels,
                                        block_depth=block_depth, min_freq=min_freq,
                                        max_freq=max_freq, embedding_dims=embedding_dims,
                                        min_signal_rate=min_signal_rate,
                                        max_signal_rate=max_signal_rate)
ps, st = Lux.setup(rng, ddim) .|> gpu

opt = AdamW(learning_rate, (9.0f-1, 9.99f-1), weight_decay)
opt_st = Optimisers.setup(opt, ps) |> gpu
|> gpu でパラメータ達を GPU に転送する。なお GPU が利用可能でないときは gpu は何もせず入力をそのまま返すので、デバイスに合わせて gpu, cpu を書き換える必要はない。
学習ループ
学習ループの概略は以下のような感じ。
function train_step(ddim::DenoisingDiffusionImplicitModel{T}, images::AbstractArray{T, 4},
                    rng::AbstractRNG, ps, st::NamedTuple,
                    opt_st::NamedTuple) where {T <: AbstractFloat}
    (loss, st), back = Zygote.pullback(p -> compute_loss(ddim, images, rng, p, st), ps)
    gs = back((one(loss), nothing))[1]
    opt_st, ps = Optimisers.update(opt_st, ps, gs)
    return loss, ps, st, opt_st
end
...
rng_gen = Random.MersenneTwister()
Random.seed!(rng_gen, 0)
...
for epoch in 1:epochs
    losses = []
    iter = ProgressBar(data_loader)

    st = Lux.trainmode(st)
    for images in iter
        images = images |> gpu
        loss, ps, st, opt_st = train_step(ddim, images, rng, ps, st, opt_st)
        push!(losses, loss)
        set_description(iter, "Epoch: $(epoch) Loss: $(mean(losses))")
    end

    # 各エポックでの推論例の保存
    st = Lux.testmode(st)
    generated_images, _ = generate(ddim, Lux.replicate(rng_gen), # to get inference on the same noises
                                    (image_size, image_size, 3, 10), val_diffusion_steps,
                                    ps, st)
    ...
end
Zygote.pullback が自動微分の部分で、ラムダ関数を使って、モデルパラメータ ps の微分のみを計算できるようにするのがポイント。
今回のモデルはバッチ正規化を使っており、このレイヤーは学習と推論で別の動作をする。この切り替えは Lux.trainmode/Lux.testmode で行う。
乱数について注意点がある。今回のモデルではその性質上乱数生成を多用する。例えば学習でも推論でも、randn(rng, ...) のようにしてガウシアンノイズを生成しているが、この randn は乱数シード rng を mutate する。特に推論時には毎回同じ乱数シードについて評価したいので、ここでは Lux.replicate で元の乱数シードのコピーを渡している。
モデルの保存と読み込み
Lux では ps, st, opt_st の三つを与えることでスナップショットが決まる。これらは普通の Julia のオブジェクトなので、適当なライブラリでシリアライズして保存することができる。例えば BSON.jl を使うと
function save_checkpoint(ps, st, opt_st, output_dir, epoch)
    path = joinpath(output_dir, @sprintf("checkpoint_%.4d.bson", epoch))
    return bson(path, Dict(:ps => cpu(ps), :st => cpu(st), :opt_st => cpu(opt_st)))
end
となる。これをロードするときも普通に、
function load_checkpoint(path)
    d = BSON.load(path)
    return d[:ps], d[:st], d[:opt_st]
end
とすれば良い。
この辺の取り回しの良さは、パラメータや状態を明示的に扱うことの利点だと感じる。
実装全体は冒頭にリンクを貼ったリポジトリを見てほしい。
まとめ
今回の実装を通して、拡散モデルというそれなりに複雑なニューラルネットワークモデルも Julia でそれほど苦もなく実装できることがわかった。Lux は明示的にパラメータを扱うため、自分が何をしているか把握しやすく、見通しが良い。この辺は Jax に通じるものがある。
多くの人が気になるのは python に対して優位性があるのかという点だろう。個人的に Julia で深層学習をするメリットとしては
- JIT があり、気軽に
forループが書けるので、カスタムで書いたロスやデータの前処理が高速になる。特に numpy でベクトル化することが難しいような処理は Julia を使うと高速化できるはず。 - 型を付けられるので、型の解析によってバグを減らすことができる。
あたりだと感じる。
一方でフレームワークが提供する API を使って簡単に書けるモデルなら TensorFlow や PyTorch で十分だと思うし、プロダクション化のサポートやクラウドサービスとの連携は python の方が圧倒的に強い。2 速度に関しても、結局 GPU 上の計算はどちらでもあまり変わらないと思うので、CPU での処理がボトルネックでない限りは Julia が優位ということもない気がする。また、Julia は俗に TTFX と呼ばれる JIT のオーバーヘッドが存在するので、コードを書いてスクリプトを実行してデバッグというプロセスに関しては、python の方が体験として良い。
個人的には SciML で取り組まれているような、ニューラルネットワークと微分方程式の合わせ技に興味があって、その分野では Julia が優位らしいのでもう少し掘ってみたいと思っている。
一方でこのせいで色々なパッケージを組み合わせると、各パッケージ開発者が想定していなかったようなバグが生じることがあり、時々批判的なスレッドが生えたりして話題になることがある。例えばこれとか。
特にインダストリーでは大規模な分散学習をすることもあると思うが、Julia でそこまで対応できるのかは調べていない。